Hadoop重要知识点
本文最后更新于:2024年9月12日 晚上
Hadoop重要知识点理解
Hadoop核心组件
MapReduce(计算框架)
yarn (资源调度)
HDFS(hadoop的分布式文件系统,主要用于数据存储)
Common(辅助工具,包含一些依赖,jar包)
常用端口号
分类 应用 端口
namenode rpc-address 8020
namenode http-address 9870
namenode https-address 9871
datanode address 9866
datanode http-address 9864
datanode https-address 9865
resourcemanager http-address 8088
HDFS
定义
- HDFS(Hadoop Distributed File System)是一个分布式文件系统
优点
- 高容错性:多副本机制
- 适合处理大数据,可构建在廉价机器上
缺点
- 不适合低延时数据访问
- 无法高效的对大量小文件进行存储
- 只支持数据的追加,不支持文件的随机修改
- 一个文件只能有一个写,不允许多个线程同时写
HDFS组成架构
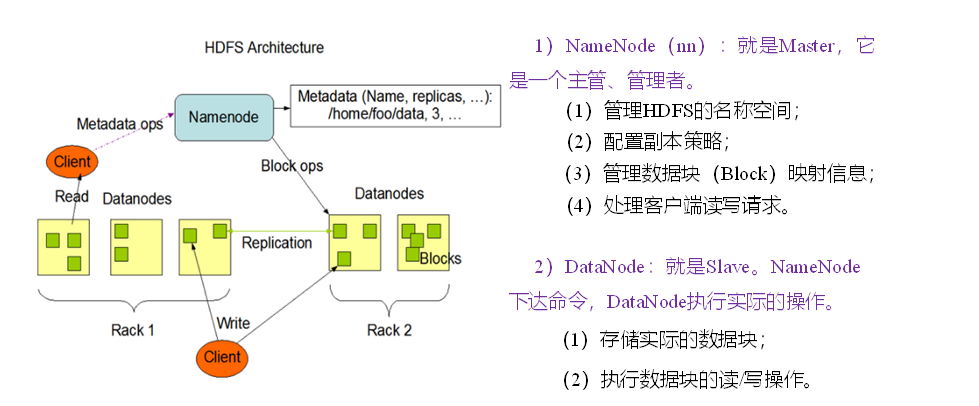
HDFS文件块大小
- hdfs中的文件在物理上是分块(BLOCK) 存储的
- 问题:为什么块大小不能设置太大,也不能设置太小?
- 设置太大:增加数据的传输时间。从磁盘传输数据的时间会明显大于定位这个块开始位置所用的时间。导致程序处理这块数据时非常慢。
- 设置太小:分块太多,查找第一个块时会消耗大量时间。寻址时间增加。造成元数据增多,而元数据存储在namenode中,会消耗更多的namenode内存。
HDFS的Shell操作
- hadoop fs + (-命令)
- hdfs dfs + (-命令)
- dfs是fs的实现类
Hadoop fs 命令分类
本地->HDFS
put #上传文件到HDFS
copyFromLocal#与put相似,支持多线程
moveFromLocal将本地文件移动到HDFS上
appendToFile#追加文件信息,只能追加本地文件信息HDFS->HDFS(命令与linux类似)
cp
mv
chown
chgrp
chmod
mkdir
du
df
cat
rmHDFS->本地
get#从HDFS上下载文件到本地
getmerge#合并下载,符合条件的全部下载到本地
copyToLocal#与get完全一样
HDFS的API操作
1 | |
HDFS的数据读写流程
HDFS写数据流程
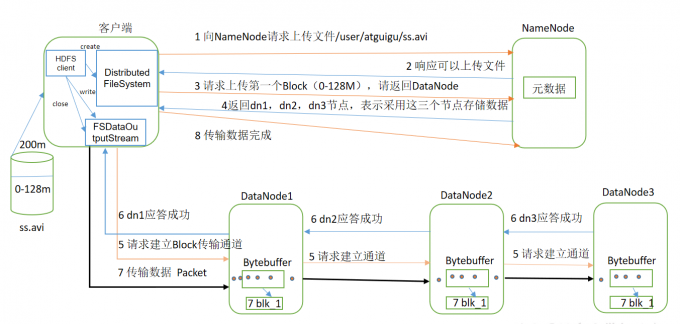
- 步骤:
- 客户端通过DistributedFileSystem模块向NameNode请求上传文件,NameNode检查目标文件是否已经存在,父目录是否存在。
- NameNode返回是否可以上传的一个响应。
- 客户端向NameNode请求第一个BLock应该上传到那几个DataNode节点上
- NameNode返回副本个数个DataNode节点,例如dn1,dn2,dn3
- 客户端通过FSDataOutputStream模块请求建立Block传输通道
- dn1,dn2,dn3,等副本逐级应答客户端
- 应答成功后,开始传输数据(以Packet(一般为64kb)的形式),dn1收到一个Packet就会传给dn2,dn2传给dn3。dn1每传一个Packet会放入一个应答队列等待应答
- 第一个Block上传完成后,客户端再请求NameNode上传第二个Block的服务器。
DataNode的选择
- 每一块数据存到哪些DataNode节点上,NameNode会进行选择。
- 在HDFS写数据的过程中,NameNode会选择距离待上传数据最近距离的DataNode接收数据。
- HDFS会通过机架感知技术,得到网络拓扑图,根据网络拓扑图选择最近的节点
- 那其他的副本是怎样选择的呢?:1.第一个副本再Client所处的节点上(自己距离自己最近),如果客户端在集群外面,随机选择一个。2.第二个副本和第一个副本位于相同机架上,随即节点。3.第三个副本位于不同机架,随机节点。
HDFS读数据流程
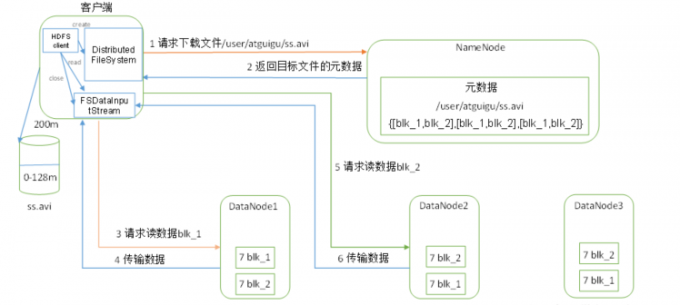
- 步骤:
- 客户端通过Distributed FileSystem向NameNode请求下载文件,NameNode通过查询元数据,找到文件块所在的DataNode地址。
- 挑选一台DataNode(就近原则,然后随机)服务器,请求读取数据
- DataNode开始传输数据给客户端(从磁盘里面读取数据输入流,以Packet为单位来做校验)。
- 客户端以Packet为单位接收,先在本地缓存,然后写入目标文件。
NameNode和SecondaryNameNode
namenode中一个元数据占150个字节的空间。
思考:NameNode中的元数据是存储在哪里的?
首先,我们做个假设,如果存储在NameNode节点的磁盘中,因为经常需要进行随机访问,还有响应客户请求,必然是效率过低。因此,元数据需要存放在内存中。但如果只存在内存中,一旦断电,元数据丢失,整个集群就无法工作了。因此产生在磁盘中备份元数据的FsImage。
这样又会带来新的问题,当在内存中的元数据更新时,如果同时更新FsImage,就会导致效率过低,但如果不更新,就会发生一致性问题,一旦NameNode节点断电,就会产生数据丢失。因此,引入Edits文件(只进行追加操作,效率很高)。每当元数据有更新或者添加元数据时,修改内存中的元数据并追加到Edits中。这样,一旦NameNode节点断电,可以通过FsImage和Edits的合并,合成元数据。
但是,如果长时间添加数据到Edits中,会导致该文件数据过大,效率降低,而且一旦断电,恢复元数据需要的时间过长。因此,需要定期进行FsImage和Edits的合并,如果这个操作由NameNode节点完成,又会效率过低。因此,引入一个新的节点SecondaryNamenode,专门用于FsImage和Edits的合并。
工作机制
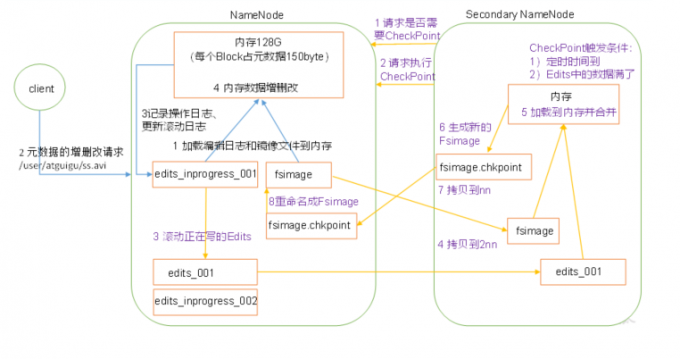
具体步骤:
- 第一阶段:NameNode
- 第一次启动NameNode,格式化后,创建Fsimage和Edits文件。如果不是第一次启动,直接加载日志文件和镜像文件到内存中去
- 客户端对元数据的增删改请求
- NameNode记录操作日志到Edits文件,更新滚动日志(当这一份日志已满,或者定时时间到了,重新创建一份新的日志文件(增删改记录写在新文件中),将旧的日志文件写到SecondaryNameNode中去)。
- NameNode在内存中进行增删改操作
- 第二阶段:SecondaryNameNode
- 2nn询问nn是否需要CheckPoint,直接带回返回结果
- 请求执行CheckPoint(触发条件:1.2nn每隔一小时执行一次。2.当操作次数达到1百万时)
- nn滚动正在写的Edits日志
- 将滚动前的日志文件和镜像文件拷贝到SecondaryNameNode中
- 2nn将从nn拷贝过来的日志文件和镜像文件在内存中合并
- 生成新的镜像文件fsimage.chkpoint
- 将新生成的镜像文件fsimage.chkpoint写到NameNode中
- NameNode将fsimage.chkpoint重新命名成fsimage。
- 第一阶段:NameNode
集群安全模式
集群在安全模式下,不能执行写操作,读操作会被延迟
在集群刚刚启动,或者集群的存储快要到达上限时会进入集群安全模式。
HDFS架构-联邦架构
- 
- 解决单个namenode的压力过大的问题。
- 扩展namenode,每个NN共用一个集群里的存储资源,每个NameNode都可以单独对外提供服务。
- 集群规模特别大时,可采用HA(高可用)+Federation(联邦)的部署方案
DataNode
DataNode工作机制
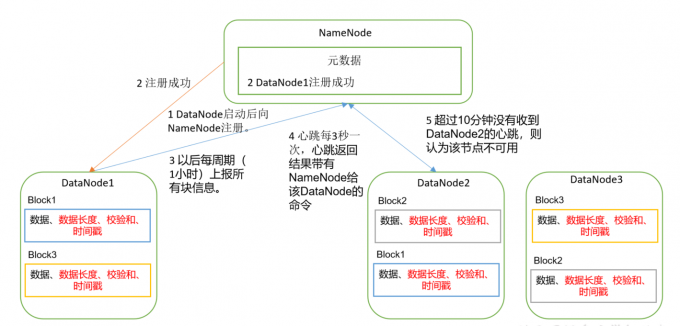
- 一个数据块在DataNode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和(保证数据完整性),以及时间戳。
- DataNode启动后向NameNode注册,通过后,周期性(1小时)的向NameNode上报所有的块信息。
- 心跳是每3秒一次,心跳返回结果带有NameNode给该DataNode的命令如复制块数据到另一台机器,或删除某个数据块。如果超过10分钟没有收到某个DataNode的心跳,则认为该节点不可用。
- 集群运行中可以安全加入和退出一些机器。(通过配置黑白名单)
- 添加到白名单的主机节点,都允许访问NameNode,不在白名单的主机节点,都会被退出。
- 在黑名单上面的主机都会被强制退出。(进入黑名单那后状态变为不可用10分钟+30s 后退役)
- 不允许白名单和黑名单中同时出现同一个主机名称
MapReduce概述
MapReduce是一个分布式运算程序的编程框架,是用户开发“基于Hadoop的数据分析应用”的核心框架。
MapReduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个Hadoop集群上。
一个完整的MapReduce程序在分布式运行时有三类实例进程:
(1)MrAppMaster:负责整个程序的过程调度及状态协调。
(2)MapTask:负责Map阶段的整个数据处理流程。
(3)ReduceTask:负责Reduce阶段的整个数据处理流程。
WC实例:
Mapper代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package com.zt3019.wordcount;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;
import java.io.IOException;
//(输入类型:框架会将数据分成一行一行的,LongWritable表示这一行的第一个字符的索引,Text表示这一行内容)KEYIN,VALUEIN,(输出类型:单词,1)KEYOUT,VALUEOUT
public class WordCountMapper extends Mapper<LongWritable,Text,Text, IntWritable> {
/**
* 框架将数据拆成一行一行输入进来,我们把数据变成(单词,1)的形式
* @param key 行号
* @param value 行内容
* @param context 任务本身
* @throws IOException
* @throws InterruptedException
*/
Text word=new Text();
IntWritable one=new IntWritable(1);
@Override
protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
//拿到一行数据
String line=value.toString();
//将一行拆成很多单词
String[] words = line.split(" ");
//将(单词,1)写回框架
for (String word : words) {
this.word.set(word);
context.write(this.word,this.one);
}
}
}Redecer
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package com.zt3019.wordcount;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;
import java.io.IOException;
//输入为map的输出,输出为(单词,单词出现的次数)
public class WordCountReducer extends Reducer<Text, IntWritable,Text,IntWritable> {
int sum=0;
IntWritable value=new IntWritable();
/**
* 框架把数据按照单词分好组输入给我们,我们将同一个单词的次数相加
* @param key 单词
* @param values 这个单词所有的1
* @param context 任务本身
* @throws IOException
* @throws InterruptedException
*/
@Override
protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
//累加单词出现的次数
for (IntWritable value : values) {
sum+=value.get();
}
//封装结果
value.set(sum);
//将结果写回框架
context.write(key,value);
}
}Driver(本地集群模式)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48package com.zt3019.wordcount;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import java.io.IOException;
public class WordCountDriver{
public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
Configuration configuration = new Configuration();
//配置yarn集群运行
//core-site.xml配置文件
configuration.set("fs.defaultFS", "hdfs://hadoop100:8020");
//MapRedece-site.xml配置文件
configuration.set("mapreduce.framework.name","yarn");
//是否允许向linux提交任务
configuration.set("mapreduce.app-submission.cross-platform","true");
configuration.set("yarn.resourcemanager.hostname","hadoop102");
//1.获取job实例
Job job= Job.getInstance(configuration);
//2.设置jar包
job.setJarByClass(WordCountDriver.class);
//3.设置Mapper和Reducer
job.setMapperClass(WordCountMapper.class);
job.setReducerClass(WordCountReducer.class);
//4.设置Map和Reduce的输出类型
//设置Map的输出类型
job.setMapOutputKeyClass(Text.class);
job.setMapOutputValueClass(IntWritable.class);
//设置Reduce的输出类型
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
//5.设置输入输出文件
FileInputFormat.setInputPaths(job,new Path(args[0]));
FileOutputFormat.setOutputPath(job,new Path(args[1]));
//6.提交job
//提交任务得到运行结果,成功或者失败
//提交流程都在这个方法中,一些job的配置都可以在上面设置。
boolean b = job.waitForCompletion(true);
System.exit(b ? 0:1);
}
}提交到集群上运行,先maven打包,
1
yarn jar 包名 主类引用(reference) args[0](输入路径) args[1](输出路径)
Hadoop压缩
压缩格式 hadoop自带? 算法 文件扩展名 是否可切分 换成压缩格式后,原来的程序是否需要修改 DEFLATE 是,直接使用 DEFLATE .deflate 否 和文本处理一样,不需要修改 Gzip 是,直接使用 DEFLATE .gz 否 和文本处理一样,不需要修改 bzip2 是,直接使用 bzip2 .bz2 是 和文本处理一样,不需要修改 LZO 否,需要安装 LZO .lzo 是 需要建索引,还需要指定输入格式 Snappy 否,需要安装 Snappy .snappy 否 和文本处理一样,不需要修改
Hadoop序列化
序列化就是把内存中的对象,转换成字节序列(或其它数据传输协议)以便于存储到磁盘(持久化)和网络传输。
反序列化就是将收到的字节序列(或其它数据传输协议)或者是磁盘中持久化的数据,转换成内存中的对象。
为什么要序列化:一般来说,“活的”对象只存储在内存中,关机断电就没有了,而且“活的”对象只能由本地进程使用,不能被发送到网络上的另外一台计算机。而序列化可以存储“活的”对象,可以将“活的”对象发送到远程计算机。
自定义的数据类型要实现Writable接口实现序列化,反序列功能
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76package com.zt3019.flow;
import org.apache.hadoop.io.Writable;
import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;
public class FlowBean implements Writable {
private long upFlow;
private long downFlow;
private long sumFlow;
public void set(long upFlow,long downFlow){
this.upFlow=upFlow;
this.downFlow=downFlow;
this.sumFlow=upFlow+downFlow;
}
@Override
public String toString() {
return "FlowBean{" +
"upFlow=" + upFlow +
", downFlow=" + downFlow +
", sumFlow=" + sumFlow +
'}';
}
public void setUpFlow(long upFlow) {
this.upFlow = upFlow;
}
public void setDownFlow(long downFlow) {
this.downFlow = downFlow;
}
public void setSumFlow(long sumFlow) {
this.sumFlow = sumFlow;
}
public long getDownFlow() {
return downFlow;
}
public long getSumFlow() {
return sumFlow;
}
public long getUpFlow() {
return upFlow;
}
/**
* 序列化
* 将对象数据写出到框架指定的地方
* @param dataOutput 数据的容器
* @throws IOException
*/
public void write(DataOutput dataOutput) throws IOException {
dataOutput.writeLong(upFlow);
dataOutput.writeLong(downFlow);
dataOutput.writeLong(sumFlow);
}
/**
* 反序列化
*从框架指定地方读取数填充对象
* @param dataInput 数据的容器
* @throws IOException
*/
public void readFields(DataInput dataInput) throws IOException {
this.upFlow=dataInput.readLong();
this.downFlow=dataInput.readLong();
this.sumFlow=dataInput.readLong();
}
}
MapReduce框架原理
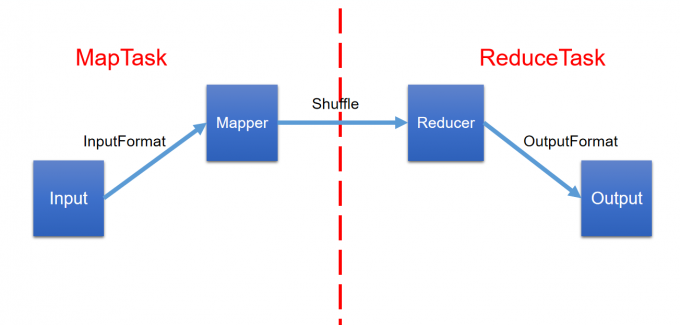
MapReduce的数据流
InputFormat
InputFormat实现数据变成K,V值
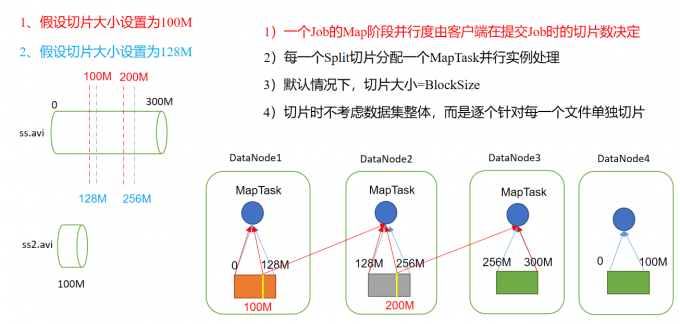
数据切片与MapTask并行度决定机制
*
job提交流程源码重要流程(客户端向集群提交的作业)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38waitForCompletion()//等待提交任务
public void submit(){
ensureState()//1.确认job状态是定义的
setUserNewAPI()//2.设置新的API
connect()//获取连接
}
// 1建立连接
connect();
// 1)创建提交Job的代理
new Cluster(getConfiguration());
// (1)判断是本地yarn还是远程
initialize(jobTrackAddr, conf);
// 2 提交job
submitter.submitJobInternal(Job.this, cluster)
// 1)创建给集群提交数据的Stag路径
Path jobStagingArea = JobSubmissionFiles.getStagingDir(cluster, conf);
// 2)获取jobid ,并创建Job路径
JobID jobId = submitClient.getNewJobID();
// 3)拷贝jar包到集群
copyAndConfigureFiles(job, submitJobDir);
rUploader.uploadFiles(job, jobSubmitDir);
// 4)计算切片,生成切片信息,数据那一块给哪一个MapTask处理
writeSplits(job, submitJobDir);
maps = writeNewSplits(job, jobSubmitDir);
input.getSplits(job);
// 5)向Stag路径写XML配置文件
writeConf(conf, submitJobFile);
conf.writeXml(out);
// 6)提交Job,返回提交状态
status = submitClient.submitJob(jobId, submitJobDir.toString(), job.getCredentials());InputFormat两个重要过程
- 切片:将文件切片,逻辑上的划分。默认是FileInputFormat,默认就是分块大小。在客户端完成,切几个片就有几个MapTask
- RecordReader:对于给定的一个切片得到一个RecordReader,将数据划分成指定的K,V值,传到Map中,作为Map的输入。发生在MapTask中。
自定义InputFormat方法
- 自定义一个类继承FileInputFormat
- Split:重写isSplitable(),将文件切片,可以自己定义切片规则,返回false 表示不切割
- RecordReader:重写createRecordReader(),实现自定义输入到Map的K,V值
Map阶段
- MapTask: Map阶段实际执行MapTask.run()方法,MapTask是一个Map的实现类
- Mapper:在MapTask.run方法中会调用Mapper对象的map方法
- map: 定义在Mapper中的方法
Shuffle机制
shuffle负责整理数据
shuffle流程
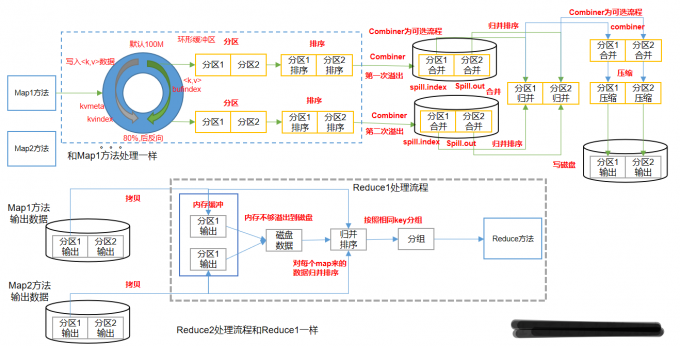
- MapTask收集map()方法输出的KV对,放到环形内存缓冲区中
- 在内存缓冲区中会进行快速排序,不断溢写到本地磁盘文件
- 多个溢出的文件会被合成大的溢出文件(溢写到磁盘耗时间,耗资源)
- 在溢出过程和合并过程中,都调用Partitiner进行分区和针对Key 进行排序,在环形缓冲区中溢出时进行快速排序,在合并时进行归并排序。
- ReduceTask根据自己的分区号,去各个MapTask机器上取相应的结果分区数据
- ReduceTask 会取到来自不同MapTask 的同一个分区结果文件,ReduceTask会将这些文件再进行合并(归并排序)
- 合并成大文件后,shuffle过程结束,后面进入ReduceTask的逻辑运算过程(从文件中取出一个一个的键值对Gruop,调用用户自定义的reduce()方法)
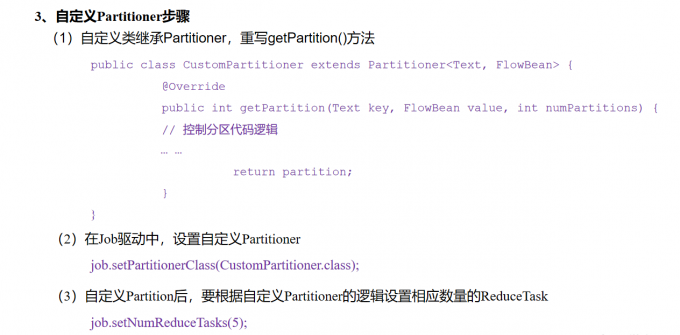
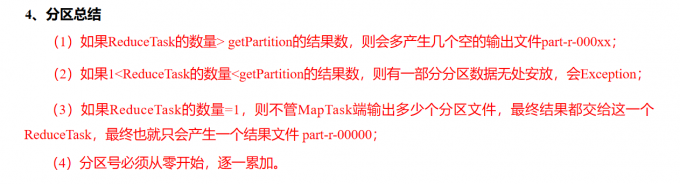
Partition分区
当设置多个ReduceTask时,需要对MapTask输出来的数据进行分区。若ReduceTask数量为1,不执行分区过程。ReduceTask数量默认为1
适应于将将结果按照条件输出到不同分区文件中(分区)。例如:词频统计中分连个区A-M一个分区,M-Z一个分区
当数据量太大时,将多个MapTask得到的结果放到一个Reduce中合并时会非常慢,为了提高效率,需要并行处理,即设置多个ReduceTask处理。ReduceTask需要设置,估算数据业务的量
分区在环形缓冲区时就已经开始进行了
默认分区是根据key的hashCode对ReduceTasks个数取模得到的。用户没法控制哪个key存储到哪个分区。
1
2
3
4
5
6
7
public class HashPartitioner<K, V> extends Partitioner<K, V> {
public int getPartition(K key, V value, int numReduceTasks) {
return (key.hashCode() & Integer.MAX_VALUE) % numReduceTasks;
}
//&的目的是去负号
}
三次排序
- 一次快排,两次归并排序
- 对于MapTask,它会将处理的结果暂时放到环形缓冲区中,当环形缓冲区使用率达到一定阈值后,再对缓冲区中的数据进行一次快速排序,并将这些有序数据溢写到磁盘上,而当数据处理完毕后,它会对磁盘上所有文件进行归并排序。
- 对于ReduceTask,它从每个MapTask上远程拷贝相应的数据文件,如果文件大小超过一定阈值,则溢写磁盘上,否则存储在内存中。如果磁盘上文件数目达到一定阈值,则进行一次归并排序以生成一个更大文件;如果内存中文件大小或者数目超过一定阈值,则进行一次合并后将数据溢写到磁盘上。当所有数据拷贝完毕后,ReduceTask统一对内存和磁盘上的所有数据进行一次归并排序。
三个比较器(一个排序比较器,两个分组比较器)
- 排序比较器
- Reducer分组比较器
- Combiner分组比较器
Hadoop中所有比较器默认都是WritableComparator(默认调用key的compareTo()方法)
自定义排序的两种方法
- 实现接口WritableComparable(该接口继承Writable,Comparable)
- 自定义一个类的专用比较器,在Job中覆盖Comparator,自定义的比较器要继承WritableComparator
Combiner合并
- Combiner与Reducer的区别:Combiner是在每一个MapTask所在节点运行,Reducer是接受全局所有Mapper的输出结果。
- Combiner对每一个MapTask的输出进行局部汇总,以减少IO(网络IO,和本地IO)。
- Combiner默认不开启,要根据情况使用。能够应用的前提是不影响最终的业务逻辑。
GroupComparator分组
- 分组比较器,根据排好顺序的数据,根据Key值进行分组
- 对Reduce阶段的数据根据某一个或几个字段进行分组。
- 分组比较器默认也是WritableComparator(默认调用key的compareTo()方法),当排序和分组比较方案不同时,需要自定义其中的一个比较器。
- 自定义分组比较器步骤:(1)自定义类继承WritableComparator(2)重写compare()方法 (3)创建一个构造将比较对象的类传给父类
MapReduce传输数据的方式
- 为了提高传输效率,传输的是用Writable序列化好的序列化数据
- 数据在从Map出来进入到到环形缓冲区时进行序列化,进入环形缓冲区的数据已经完成了序列化。之后的数据流动都是序列化的数据的流动
- 之后的排序先反序列化再实现排序
环形缓冲区
- 一边写索引,一边写数据
- 在环形缓冲区进行排序时,不改变数据的位置,改变索引的位置
OutputFormat
将Reduce处理完的K,V值持久化到文件
几种实现
- 默认的文本输出TextOutputFormat,把每条记录写为文本行,利用K,V的toString()方法将其转为字符串。
- SequenceFileOutputFormat:将K,V值序列化成文件放到磁盘上
- 自定义OutputFormat
源码重要方法
- checkOutputSpecs()检查输出参数
- getOutputCommitter()获取outputformat提交器(保证output被正确提交)
- 自定义outputformat主要实现RecordWriter()。实现接收K,V值并将K,V值处理
MapReduce工作机制
MapReduce哪些阶段可以进行压缩
- map的输入端(主要看数据大小和切片,lzo,bzip2)
- map的输出端(主要考虑速度,snappy,Lzo)
- reduce的输出端(看需求,是要继续做mapreduce的输出,还是直接做分析的数据等)
MapTask工作机制
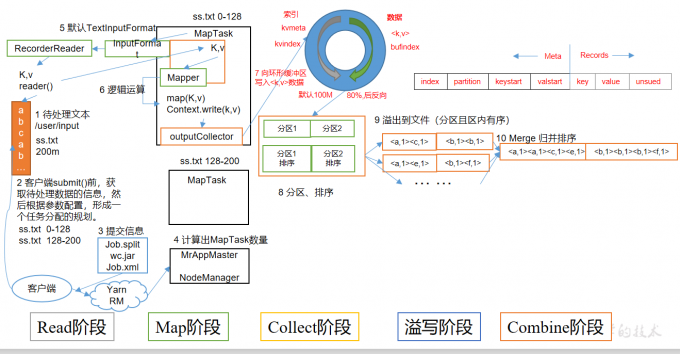
(1)Read阶段:MapTask通过用户编写的RecordReader,从输入InputSplit中解析出一个
(2)Map阶段:该节点主要是将解析出的key/value交给用户编写map()函数处理,并产生一系列新的key/value。
(3)Collect收集阶段:在用户编写map()函数中,当数据处理完成后,一般会调用OutputCollector.collect()输出结果。在该函数内部,它会将生成的key/value分区(调用Partitioner),并写入一个环形内存缓冲区中。
(4)Spill阶段:即“溢写”,当环形缓冲区满后,MapReduce会将数据写到本地磁盘上,生成一个临时文件。需要注意的是,将数据写入本地磁盘之前,先要对数据进行一次本地排序,并在必要时对数据进行合并、压缩等操作。
个key/value。
溢写阶段详情:
步骤1:利用快速排序算法对缓存区内的数据进行排序,排序方式是,先按照分区编号Partition进行排序,然后按照key进行排序。这样,经过排序后,数据以分区为单位聚集在一起,且同一分区内所有数据按照key有序。
步骤2:按照分区编号由小到大依次将每个分区中的数据写入任务工作目录下的临时文件output/spillN.out(N表示当前溢写次数)中。如果用户设置了Combiner,则写入文件之前,对每个分区中的数据进行一次聚集操作。
步骤3:将分区数据的元信息写到内存索引数据结构SpillRecord中,其中每个分区的元信息包括在临时文件中的偏移量、压缩前数据大小和压缩后数据大小。如果当前内存索引大小超过1MB,则将内存索引写到文件output/spillN.out.index中。
(5)Combine阶段:当所有数据处理完成后,MapTask对所有临时文件进行一次合并,以确保最终只会生成一个数据文件。
当所有数据处理完后,MapTask会将所有临时文件合并成一个大文件,并保存到文件output/file.out中,同时生成相应的索引文件output/file.out.index。
在进行文件合并过程中,MapTask以分区为单位进行合并。对于某个分区,它将采用多轮递归合并的方式。每轮合并io.sort.factor(默认10)个文件,并将产生的文件重新加入待合并列表中,对文件排序后,重复以上过程,直到最终得到一个大文件。
让每个MapTask最终只生成一个数据文件,可避免同时打开大量文件和同时读取大量小文件产生的随机读取带来的开销。
ReduceTask阶段
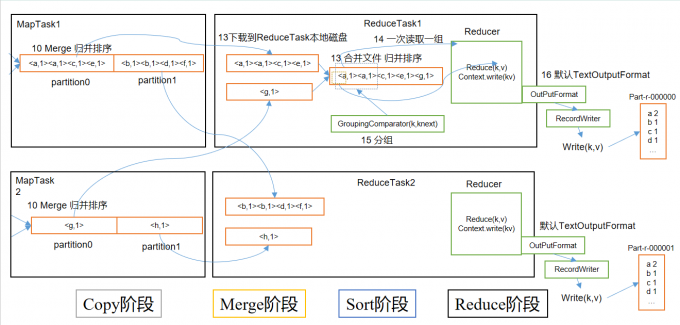
(1)Copy阶段:ReduceTask从各个MapTask上远程拷贝一片数据,并针对某一片数据,如果其大小超过一定阈值,则写到磁盘上,否则直接放到内存中。
(2)Merge阶段:在远程拷贝数据的同时,ReduceTask启动了两个后台线程对内存和磁盘上的文件进行合并,以防止内存使用过多或磁盘上文件过多。
(3)Sort阶段:按照MapReduce语义,用户编写reduce()函数输入数据是按key进行聚集的一组数据。为了将key相同的数据聚在一起,Hadoop采用了基于排序的策略。由于各个MapTask已经实现对自己的处理结果进行了局部排序,因此,ReduceTask只需对所有数据进行一次归并排序即可。
(4)Reduce阶段:reduce()函数将计算结果写到HDFS上。
### Join多种应用
* Reducejoin:
- Map段主要工作:为来自不同表或文件的key/value对,***打标签以区别不同来源的记录***。然后用连接字段作为key ,其余部分和新加的标志作为value,最后进行输出。
- Reduce端主要工作:在Reduce端以连接字段作为key的分组已经完成,我们只需要在每一个分组中将***来源不同文件的记录(在Map阶段已经打标签)分开***,最后进行合并。
- 缺点:这种方式中,合并操作是在Reduce阶段完成,Reduce端的处理压力太大,Map节点的运算负载很低,资源利用率不高,且在Reduce阶段容易产生数据倾斜。
* Mapjoin
1.使用场景
Map Join适用于一张表十分小、一张表很大的场景。
2.优点
思考:在Reduce端处理过多的表,非常容易产生数据倾斜。怎么办?
在Map端缓存多张表,提前处理业务逻辑,这样增加Map端业务,减少Reduce端数据的压力,尽可能的减少数据倾斜。
3.具体办法:采用DistributedCache
(1)在Mapper的setup阶段,将文件读取到缓存集合中。
(2)在驱动函数中加载缓存。
// 缓存普通文件到Task运行节点。
job.addCacheFile(new URI("file://e:/cache/pd.txt"));
Yarn资源调度器
Yarn基本架构和工作机制
基本架构
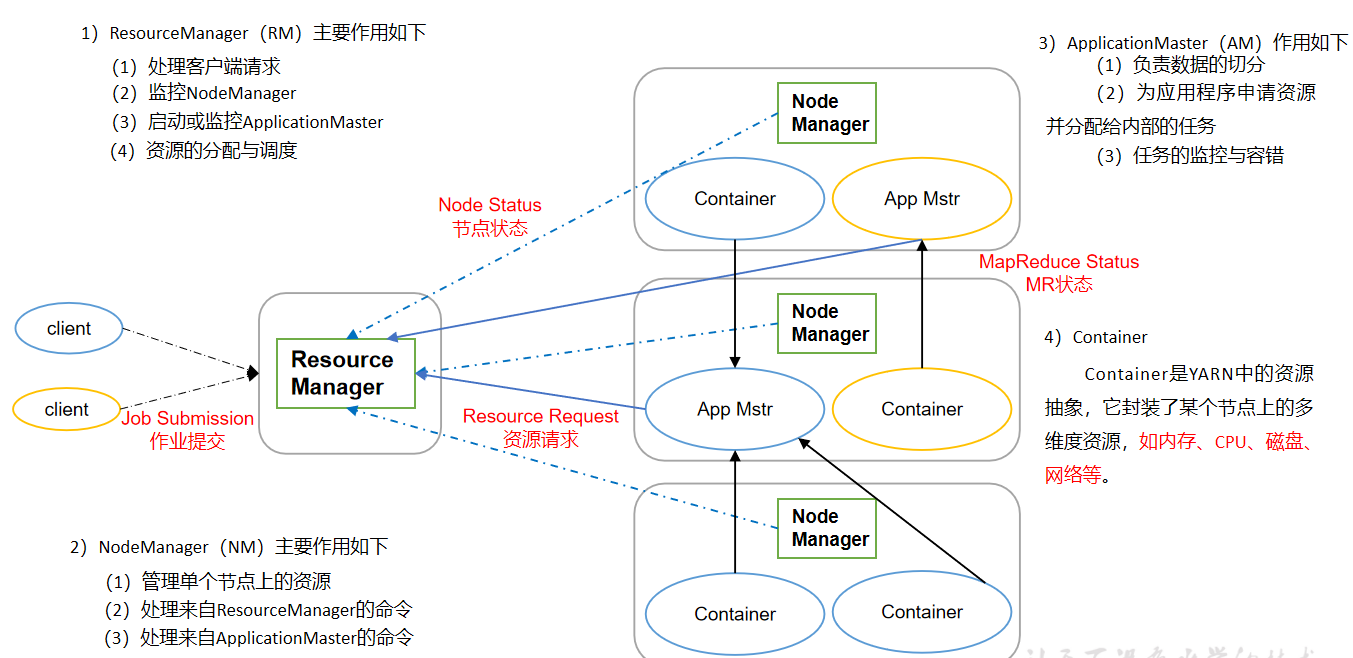
Yarn工作流程
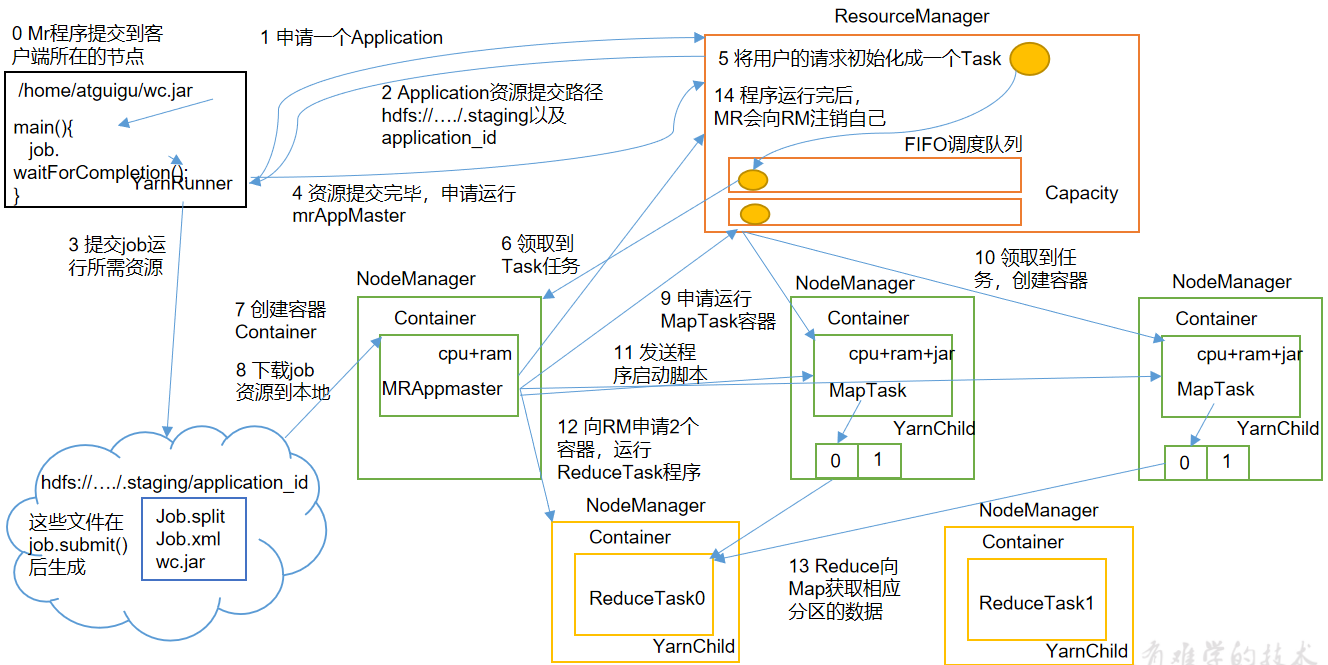
Yarn工作步骤
- 客户端执行程序job.waitForCompletion
- 申请一个Application
- 返回Application资源提交临时路径和job_Id
- 客户端提交job运行必要资源Job.split(分片信息),Job.xml(配置信息),Wc.jar(所需的必要Jar包)。提交到HDFS
- 资源提交完毕,申请运行AppMaster
- ResourceManager将用户的请求初始化成一个Task资源申请,放入资源调度器等待调度
- 资源调度器中的任务会分配到一个NodeManager中
- NodeManager会根据任务创建一个容器,在容器中运行对应的AppMaster
- AppMaster获取必要资源到本地
- AppMaster再向ResourceManager请求运行MapTask资源申请
- ResourceManager指定一个NodeManager领取MapTask任务,创建容器,运行MapTask
- AppMaster向执行MapTask的NodeManager发送程序启动脚本
- 同理AppMaster向RM请求运行ReduceTask资源申请,创建容器运行ReduceTask
- Reduce向Map获取相应的分区数据
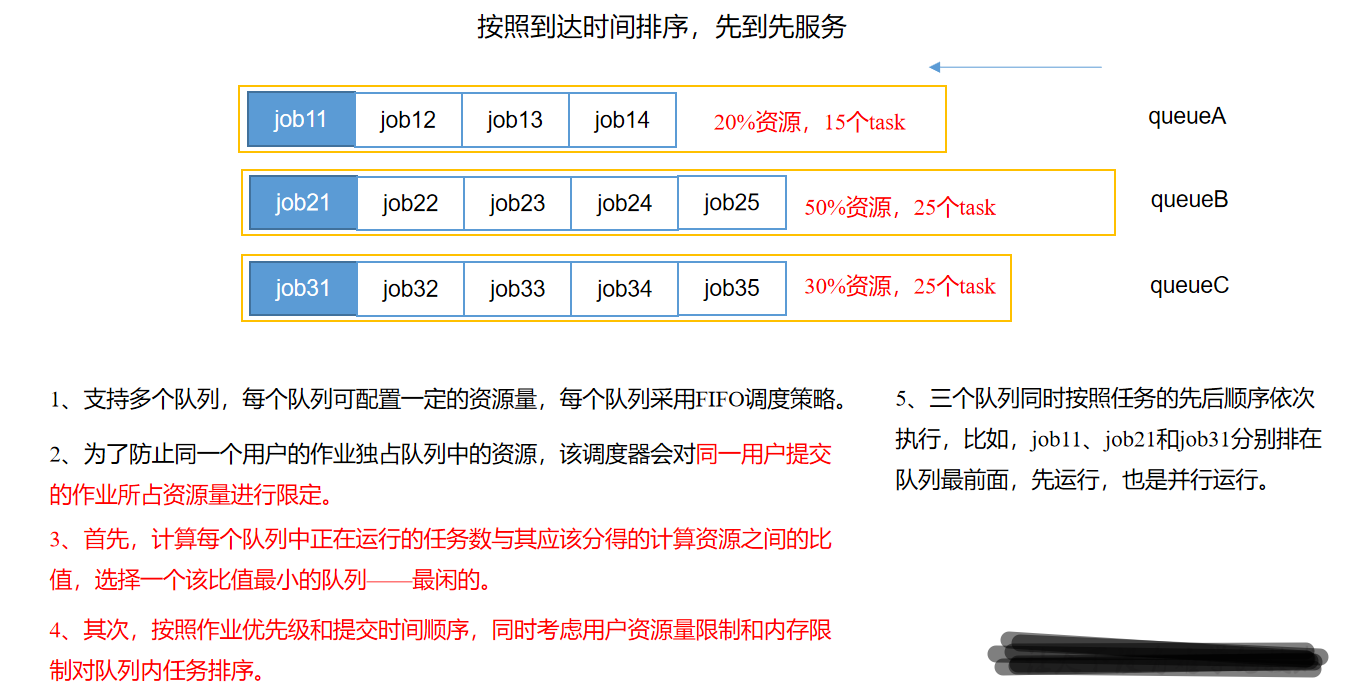
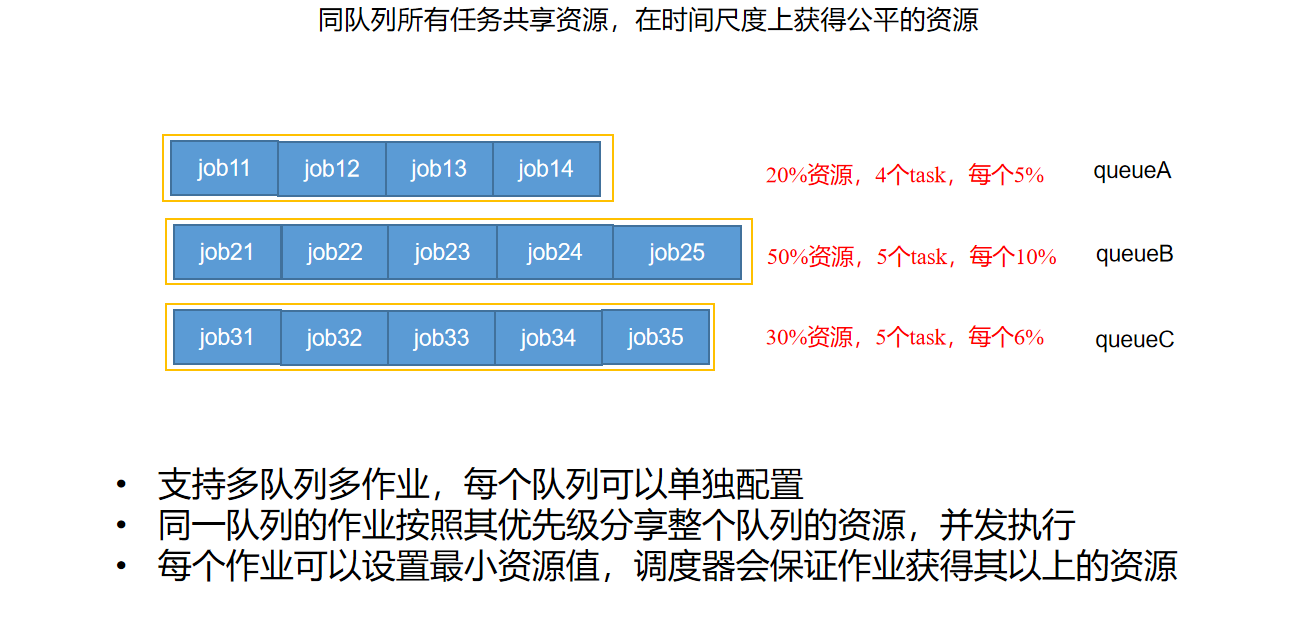
资源调度器:FIFO、Capacity Scheduler和Fair Scheduler。Hadoop3.1.3默认的资源调度器是Capacity Scheduler。
FIFO,队列形式。基本不用
Capacity Scheduler,几个并行的FIFO。当集群资源不紧张时,采用此方式
Fair Scheduler 公平调度器。能最大程度利用集群的资源
Hadoop常见优化
数据倾斜问题:某个区域的数据量远远大于其它区域例如Map端和Reduce端的数据倾斜
- 自定义分区,基于对原始数据的认知进行自定义分区。
- Combine:Combine可以大量地减少数据倾斜。
- 采用Mapjoin,因为Reducejoin对Reduce端的压力非常大
参数优化提升MapReduce 性能
容错相关参数(MapReduce性能优化)
配置参数 参数说明 mapreduce.map.maxattempts 每个Map Task最大重试次数,一旦重试参数超过该值,则认为Map Task运行失败,默认值:4。 mapreduce.reduce.maxattempts 每个Reduce Task最大重试次数,一旦重试参数超过该值,则认为Map Task运行失败,默认值:4。 mapreduce.task.timeout Task超时时间,经常需要设置的一个参数,该参数表达的意思为:如果一个Task在一定时间内没有任何进入,即不会读取新的数据,也没有输出数据,则认为该Task处于Block状态,可能是卡住了,也许永远会卡住,为了防止因为用户程序永远Block住不退出,则强制设置了一个该超时时间(单位毫秒),默认是600000。如果你的程序对每条输入数据的处理时间过长(比如会访问数据库,通过网络拉取数据等),建议将该参数调大,该参数过小常出现的错误提示是“AttemptID:attempt_14267829456721_123456_m_000224_0 Timed out after 300 secsContainer killed by the ApplicationMaster.”。
小文件优化方法
- 小文件的缺点:1.会占用namenode大量的内存资源。2.索引文件过大使得检索速度变慢。
- 优化:1.Sequence File:Sequence File由一系列的二进制key/value组成,Input如果key为文件名,value为文件内容,则可以将大批小文件合并成一个大文件。
- CombineFileInputFormat:用于将多个文件合并成一个单独的split。
MapReduce 优化
- InputFormat阶段 :1. 合并小文件
- Map阶段:1.减少溢写(Spill)次数。2.减少合并(Merge)次数
- Reduce阶段
- 合理设置Map和Reduce数:两个都不能设置太少,也不能设置太多。太少,会导致Task等待,延长处理时间;太多,会导致Map,Reduce任务竞争资源,造成处理超时等待。
- 设置Map,Reduce共存,调整slowstart.completedmaps参数,使Map运行到一定程度后,Reduce也开始运行,减少Reduce的等待时间。
- 规避使用Reduce,因为Reduce在用于连接数据集的时候会产生大量的网络消耗。
- 合理设置Reduce端的Buffer
- OutputFormat阶段
- 采用数据压缩
- 使用SequenceFile二进制文件
本博客所有文章除特别声明外,均采用 CC BY-SA 4.0 协议 ,转载请注明出处!